AI 도구 / Qwen3-TTS
독립 리뷰 · 제휴 링크 없음
 Qwen3-TTS
알리바바 Qwen 팀이 Apache 2.0으로 공개한 음성 합성 모델입니다. 내 컴퓨터에서 돌리면 요금이 없고, 비용은 장비와 시간입니다. 편집부는 로봇 편 글 듣기 4개 언어와 강의 음성을 맥에서 이 모델로 만듭니다.
공식 사이트 ↗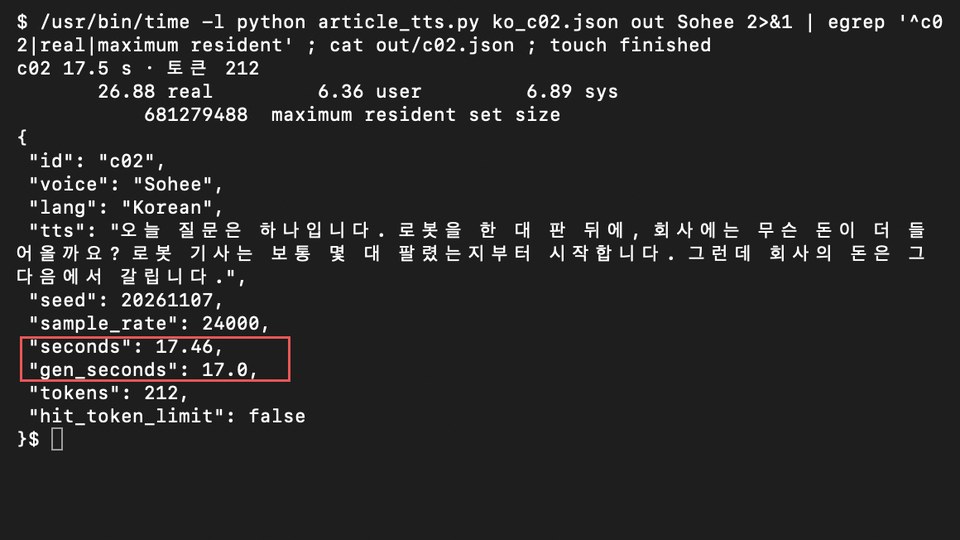
- 잘하는 것
- 내 컴퓨터에서 돌리는 10개 언어 음성 합성 · 말투 지시 · 음성 복제
- 과금 방식
- 공개 모델은 무료 · API는 qwen3-tts-flash 1만 자당 $0.1(싱가포르)
- 라이선스
- Apache 2.0 · 상표권은 포함되지 않음
- 맥에서 걸린 시간(편집부 실측)
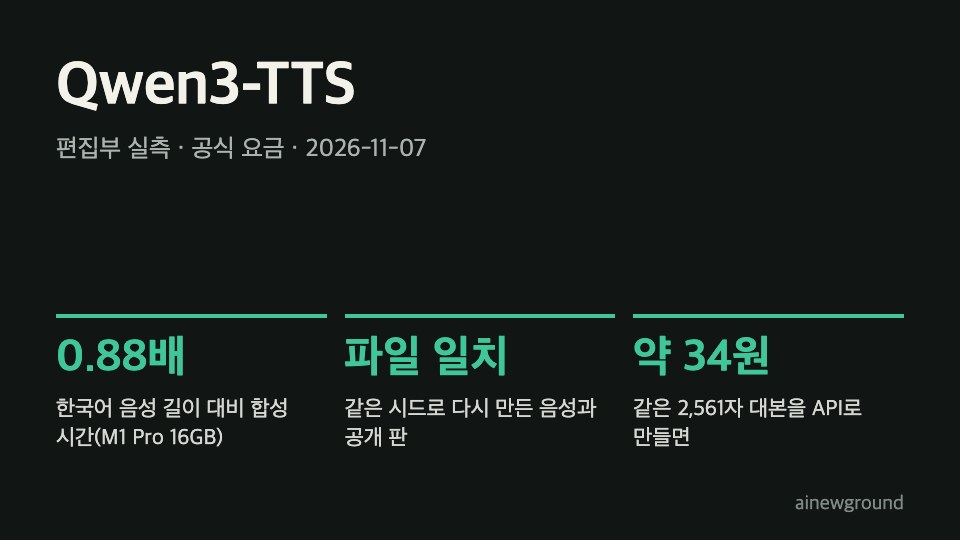
- 한국어 음성 436.9초를 383.2초에 합성(0.88배) · M1 Pro 16GB
- 같은 대본을 API로(편집부 계산)
- 2,561자 약 $0.026(약 34원)
- 한국어 기본 화자
- Sohee 1명(CustomVoice 9명 중)
- 내려받기 · 별(2026-11-07)
- 1.7B-CustomVoice 지난달 1,517,422회 · GitHub 별 14,253개
이 도구가 하는 일
Qwen3-TTS는 가입하는 서비스가 아니라 내려받는 음성 합성 모델입니다. 2026년 1월 22일 공개됐고, 정해진 화자로 읽는 CustomVoice, 설명문으로 목소리를 만드는 VoiceDesign, 짧은 음성으로 복제하는 Base로 나뉩니다. 크기는 1.7B와 0.6B가 있습니다.
같은 이름이 두 경로를 가리켜 헷갈리기 쉽습니다. 저장소의 공개 모델은 내 장비에서 돌고 요금이 없습니다. Alibaba Cloud의 qwen3-tts-flash는 글자 수로 돈을 내는 API이고, 공개 모델과 같은 모델이라는 문장을 문서에서 찾지 못했습니다. 이 글의 실측은 모두 공개 모델 쪽입니다.
이 쪽은 편집부가 실제로 공개한 로봇 편 글 듣기의 기록을 중심으로 씁니다. 돈으로는 거의 차이가 안 납니다. 한국어 2,561자 대본이 API로 약 34원이므로, 로컬을 고르는 이유는 값보다 대본을 밖으로 내보내지 않는 것과 같은 결과를 다시 만들 수 있는 것입니다.
편집부 사용 기록
- 편집부는 2026-11-07 로봇 편 글 듣기를 이 모델로 만들어 4개 언어로 공개했습니다. 화자는 한국어 Sohee · 영어 Ryan · 일본어 Ono_Anna · 중국어 Vivian이고, 맥에서는 공식 패키지 대신 mlx-audio 0.5.9와 8비트 변환 모델을 씁니다.
- 한국어 대본은 2,561자 · 15조각입니다. 처음 합성한 음성 436.9초에 생성 시간 383.2초가 걸렸습니다(0.88배). 영어는 5,594자로 395.9초에 901.1초(2.28배)가 걸렸습니다. 그때 다른 작업이 겹쳤는지 기록이 없어, 영어가 원래 느리다고 단정하지 않습니다.
- 같은 시드로 첫 조각을 다시 합성했더니 공개 판 wav와 파일 지문(md5)까지 같았습니다(2026-11-07). 생성 시간은 공개 판 27.3초, 다시 돌린 날 17.0초였습니다. 소리는 재현되고 시간은 그날 맥 상태에 따라 달라집니다.
- 시드가 같아도 문장이 바뀌면 음색이 달라집니다. 강의에서 같은 화자의 한 문장 밝기가 3,461Hz로 나와 앞 편 평균 2,551Hz와 달랐고, 편집부에서 들어 보고 느낌이 다르다고 짚었습니다. 그 뒤로 시드 후보 여러 개를 수치로 비교하고 마지막은 사람이 귀로 고릅니다(2026-10-22).
- 영어 화자에게 한국어를 읽히면 문장 맨 앞 짧은 낱말이 영어로 미끄러질 수 있습니다. Aiden이 「있습니다.」를 「Ease입니다」처럼 읽은 문장은 시드 8개 중 7개가 정상이었습니다.
- 일본어는 15조각 중 6조각을 손봤습니다. 「・」 소수점이 48% · 214%처럼 잡힌 3조각은 「点」으로 고쳤고, 숫자 177과 대본에 없는 첫소리, 계속 틀리게 잡힌 출처 수도 다시 처리했습니다. 합성 뒤 전사 대조가 없었다면 숫자 오독이 그대로 나갈 뻔했습니다.
- 기본 합성본은 쉼이 깁니다. 조각 안 쉼을 0.30초로 줄여 79.0초를 덜어 냈고, 완성본은 5분 54초 · mp3 2.8MB입니다. 한국어 전사 대조 일치율은 86.6%인데, 대본은 숫자를 말로 풀고 전사는 숫자로 적으므로 정확도로 읽으면 안 됩니다.
- 강의 한 편에서는 49문장을 합성해 전사가 불명확한 5곳을 다듬어 다시 합성한 뒤 표기 차이를 맞춰 49문장을 대조했습니다. 그 기록 시점에는 사람이 전체를 듣는 검수가 남아 있었습니다.
- 확인한 것: 2026-11-07에 저장소 안내 · 라이선스 · Hugging Face 모델 쪽 · Model Studio 요금 · 비실시간 합성 문서 · 무료 한도 문서를 다시 읽었고, 같은 날 M1 Pro 16GB에서 첫 조각을 다시 합성했습니다.
- 확인 못 한 것: 음성 복제 · 음성 설계 · 실시간 스트리밍 · 0.6B 모델 · 공식 패키지 · CUDA 환경 · DashScope API 결제를 쓰지 않아 공식 지연 97ms와 API 품질은 재지 못했습니다. 메모리는 프로세스 최대 681MB로 찍혔지만 통합 메모리 전체 사용량은 아닐 수 있습니다. 원어민 검수와 실제 휴대폰 재생 시험도 아직 없습니다.
이런 사람에게 맞습니다
글에 듣기를 붙이려는 작은 매체
대본을 고칠 때마다 다시 만들어도 글자당 요금이 없습니다. 편집부는 한 편 4개 언어 합성에 생성 시간 약 36분이 들었습니다(다시 뽑은 조각의 이전 판 제외).
대본을 밖으로 못 보내는 팀
공개 전 기사나 내부 교육 자료를 외부 API에 넣지 않고 합성합니다. 편집부는 내려받은 모델 폴더에서 바로 불러 쓰지만, 네트워크를 완전히 끊고 시험하지는 않았습니다.
같은 소리를 다시 만들어야 하는 강의 제작자
시드와 설정을 적어 두면 같은 문장을 파일까지 똑같이 재현합니다. 한 문장만 고치고 나머지를 그대로 둘 수 있습니다.
언어별 판을 혼자 만드는 사람
한 도구에 4개 언어 화자를 묶어 같은 순서로 처리합니다. 다만 일본어처럼 숫자 읽기를 언어마다 따로 고쳐야 합니다.
메모리 16GB 이상 맥이나 GPU가 이미 있는 사람
편집부 모델 폴더는 3.2GB이고 M1 Pro 16GB에서 돌렸습니다. 장비를 새로 산다면 값 비교가 뒤집힙니다.
이런 경우엔 맞지 않습니다
- 전화 상담 같은 실시간 대화: 공식 지연 97ms는 스트리밍 기준이고, 편집부는 그 경로를 쓰지 않았습니다. 맥 전체 합성은 언어별로 음성 길이의 0.87~2.28배가 걸렸습니다.
- 여러 한국어 목소리 중에서 고르고 싶은 경우: 기본 화자 9명 중 한국어 원어민은 Sohee 1명입니다. 타입캐스트처럼 성우 목록에서 고르는 도구가 맞습니다.
- 설치와 전사 대조를 할 사람이 없는 경우: 편집부는 숫자 오독을 합성 뒤 전사 대조로 찾았습니다. 듣기와 대조 없이 그대로 내보내는 작업에는 권하지 않습니다.
- 다른 사람 목소리 복제가 주목적인 경우: 편집부는 복제를 쓰지 않았으니 이 쪽의 기록이 도움이 되지 않고, 동의와 법적 검토가 먼저입니다.
핵심 기능
모델 세 갈래
CustomVoice는 정해진 화자로 읽고, VoiceDesign은 설명문으로 목소리를 만들고, Base는 짧은 음성으로 복제합니다. 편집부는 CustomVoice만 씁니다.
화자 9명
Sohee(한국어) · Ryan · Aiden(영어) · Ono_Anna(일본어) · Vivian · Serena · Uncle_Fu · Dylan · Eric(중국어와 방언)입니다. 공식 안내도 화자의 모국어로 쓰기를 권합니다.
말투 지시문
문장으로 말투를 지시합니다. 편집부의 글 듣기는 「친구에게 기사를 읽어 주듯 차분하게」에 해당하는 영어 지시문 하나를 4개 언어 모두에 씁니다.
10개 언어
중국어 · 영어 · 일본어 · 한국어 · 독일어 · 프랑스어 · 러시아어 · 포르투갈어 · 스페인어 · 이탈리아어입니다. 편집부는 앞의 4개만 만들어 봤습니다.
공식 평가표
저장소 표에서 한국어 단어 오류율은 12Hz 1.7B-Base 1.755, 같은 표의 ElevenLabs 1.865입니다. 만든 팀이 낸 값이고 Base 모델 기준이라 그대로 믿지 말고 내 대본으로 들어 보세요.
시드 재현
공식 기능 설명이 아니라 편집부 실측입니다. 같은 문장 · 화자 · 시드 · 버전이면 파일 지문(md5)까지 같은 파일이 나왔습니다. 문장이 바뀌면 음색은 달라집니다.
스트리밍과 미세 조정
저장소는 스트리밍 합성과 미세 조정(fine-tuning) 안내를 제공합니다. 편집부는 둘 다 쓰지 않아 품질과 속도를 말할 수 없습니다.
API 경로
Alibaba Cloud Model Studio의 qwen3-tts-flash입니다. 한글 · 영문 · 숫자 · 공백은 1자, 한자는 2자로 세므로 중국어 대본은 글자 수가 크게 늘어납니다.
편집부 실제 작업 순서
듣기용 대본 쓰기
본문을 그대로 읽히지 않습니다. 숫자는 그 언어의 말로 풀고, 판정 기호와 표는 줄입니다. 대본의 숫자는 본문과 대조합니다.
조각으로 나누기
로봇 편은 15조각입니다. 틀린 조각만 다시 만들 수 있고 토큰 상한에 걸렸는지도 조각마다 봅니다.
설정 고정
화자 · 지시문 · 시드 · temperature 0.9 · top_k 50 · top_p 1.0 · repetition_penalty 1.05 · max_tokens 1600을 기록합니다.
합성
조각마다 wav와 생성 시간을 남깁니다. 있는 파일은 덮어쓰지 않으니 다시 만들 조각은 먼저 옮깁니다.
음량 · 쉼 정리
조각마다 활성 음성 음량을 맞춥니다. 조각 안 쉼은 0.30초로 줄이고 조각 사이에 0.35초를 둡니다.
전사 대조
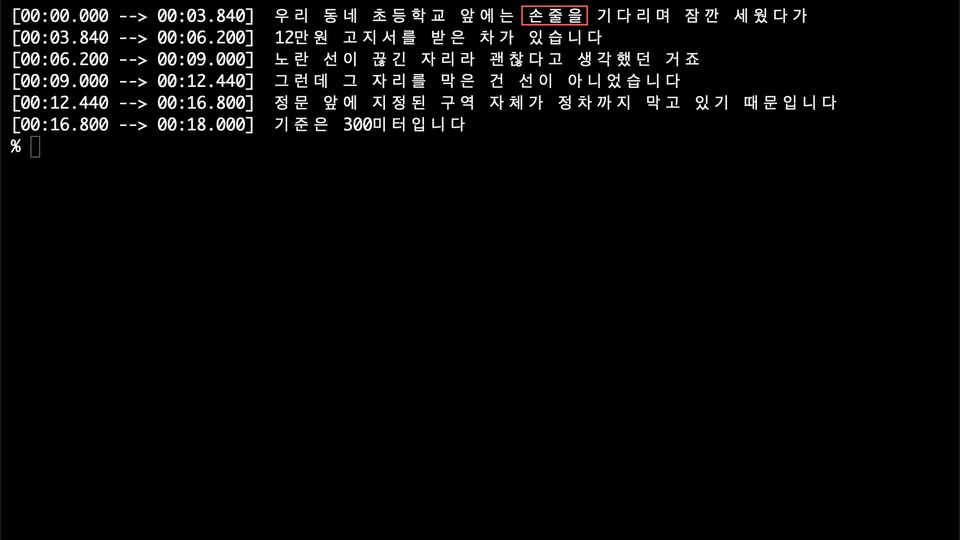
Whisper small로 조각별로 전사하고, 수치가 다르게 잡힌 곳은 medium으로 다시 봅니다. 차이가 나면 듣고 판단합니다.
고쳐서 다시
일본어는 소수점 표기를 바꾸거나 시드를 옮겼습니다. 대본에만 있던 숫자가 계속 틀리면 대본에서 뺐습니다. 본문에는 그대로 둡니다.
파일로 내보내기
mp3 64kbps 모노로 내보냅니다. 로봇 편 한국어판은 통합 음량 −19.7 LUFS · true peak −1.1 dBFS입니다.
Qwen3-TTS 요금제
내 컴퓨터(공개 모델)
- 가중치 무료 · 사용량 제한 없음
- 장비 · 전기 · 시간은 내 몫
가격 확인 2026-11-07 · 공식 요금 페이지 ↗ · ≈ 표시는 2026-10-20 환율 1달러 = 1,330.79원으로 환산한 값입니다.
공개 모델에는 요금제가 없습니다. 비교용 API 값은 Alibaba Cloud Model Studio 요금 쪽에서 2026-11-07에 읽었습니다. qwen3-tts-flash는 입력 1만 자당 싱가포르 $0.1 · 중국 본토 $0.114682, 실시간 qwen3-tts-flash-realtime은 싱가포르 $0.13입니다. 음성 복제 등록은 1개당 $0.01입니다. API 모델이 공개 가중치와 같은 모델이라는 문장은 찾지 못했습니다. 환산은 쪽 아래 환율 기준입니다.
강점
- 코드와 가중치가 Apache 2.0이라 상업 제품에 넣는 조건이 명확함
- 대본을 외부 API로 보내지 않고 합성함
- 시드를 고정하면 같은 문장을 파일까지 똑같이 다시 만들 수 있음(편집부 실측)
- 공개 모델 하나로 10개 언어와 언어별 화자를 다룸
- 말투를 문장으로 지시함(1.7B CustomVoice · VoiceDesign)
- 글자당 요금이 없어 대본을 고쳐 여러 번 다시 만들 수 있음
고려할 점
- API 무료 한도는 싱가포르 배포에만 있고 90일이면 사라집니다. qwen3-tts-flash는 110,000자이고, 쓰지 않아도 기간이 흐르며 만료분은 다시 주지 않습니다.
- 무료 한도가 끝나면 API는 자동으로 종량 과금으로 넘어갑니다. 무료 한도 뒤의 종량 요금은 환불되지 않고 출력 품질 문제로도 돌려주지 않습니다. 막으려면 Free Quota Only를 미리 켜야 합니다.
- API의 비스트리밍 음성 주소는 24시간만 유효합니다. 그 전에 내려받지 않으면 다시 합성해야 하고, 글자당 요금이 다시 듭니다.
- Apache 2.0은 Qwen 상표 사용권을 주지 않습니다(6조). 다른 사람 목소리를 복제할 권리도 이 라이선스가 주는 것이 아니므로 본인 동의와 해당 국가 법을 따로 확인해야 합니다.
- 공식 예시는 CUDA GPU 기준입니다. 맥에서 쓰는 mlx-audio와 변환 모델은 Qwen 팀 공식 경로가 아니라 버전이 바뀌면 소리와 재현이 달라질 수 있습니다. 편집부는 쓴 버전을 기록해 둡니다.
- 기본 화자 중 한국어 원어민은 Sohee 1명입니다. 말투 지시는 1.7B에서만 되고 0.6B CustomVoice 표에는 지시 기능 표시가 없습니다. 여러 한국어 목소리가 필요하면 복제나 다른 서비스를 봐야 합니다.
- 공식 지연 97ms는 스트리밍 합성의 최저값으로 적힌 수치입니다. 편집부 맥의 전체 합성 속도는 언어별로 음성 길이의 0.87~2.28배라 실시간 응답을 약속하지 않습니다.
대안
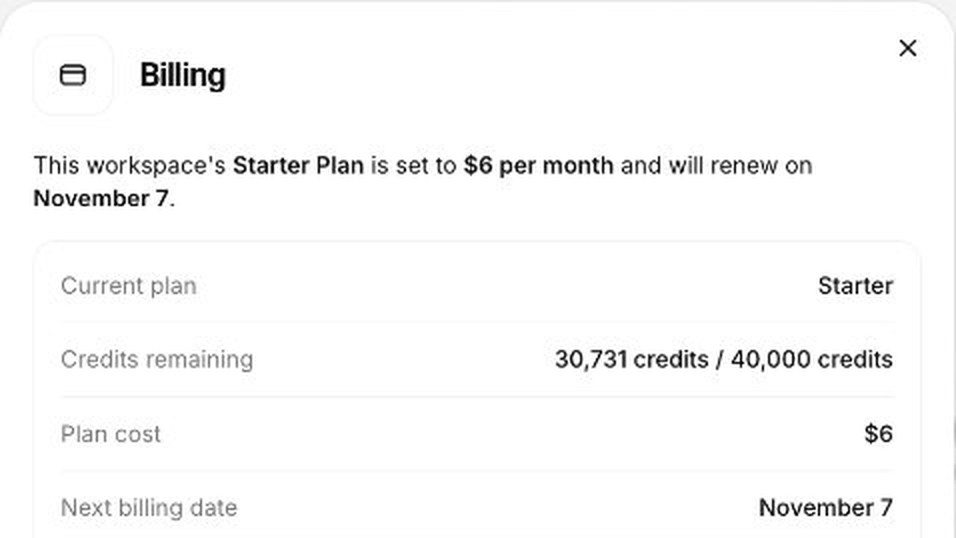
- 타입캐스트 — 성우 목록에서 한국어 목소리를 고르고 설치 없이 끝내려면 타입캐스트를 고르세요. 같은 2,561자를 1글자 1크레딧 기록과 베이직 크레딧 값으로 치면 약 845원이고, 구독이 먼저입니다.
- ElevenLabs — 영어 중심이거나 더빙 · 효과음까지 한곳에서 하려면 ElevenLabs를 고르세요. 같은 대본을 1글자 1크레딧으로 치면 Starter 크레딧 값으로 약 $0.51이고, 모델별 차감률은 편집부가 재지 않았습니다.
- Alibaba Cloud qwen3-tts-flash ↗ — 장비 없이 가끔 쓰려면 API를 고르세요. 싱가포르 기준 1만 자당 $0.1이고, 대본이 Alibaba Cloud로 나갑니다. 공개 모델과 같은 결과라고 가정하면 안 됩니다.
자주 묻는 질문
Qwen3-TTS 요금은 얼마인가요?
공개 모델은 요금이 없습니다. API qwen3-tts-flash는 2026-11-07 기준 싱가포르 1만 자당 $0.1, 중국 본토 $0.114682입니다. 값은 바뀔 수 있으니 공식 요금 쪽에서 다시 보세요.
무료로 상업적 용도에 써도 되나요?
저장소와 Hugging Face 모델 쪽은 Apache 2.0이라고 적습니다. 상표 사용권은 포함되지 않고, 복제 대상 목소리의 권리도 별도입니다. 법률 조언은 아니니 라이선스 전문을 확인하세요.
API 무료 한도는 얼마나 되나요?
qwen3-tts-flash는 싱가포르 배포에서 110,000자이고 90일 뒤 사라집니다. 편집부 로봇 편 대본 2,561자로 치면 약 42번 분량입니다. 편집부는 API를 쓰지 않아 실제 차감은 확인하지 못했습니다.
API를 해지하거나 환불받을 수 있나요?
공식 문서는 무료 한도 뒤의 종량 요금은 환불되지 않고 출력 품질 문제로도 돌려주지 않는다고 적습니다. 예상 밖 과금을 막으려면 Free Quota Only를 켜 두세요. 공개 모델은 해지할 구독 자체가 없습니다.
맥에서도 돌아가나요?
편집부는 M1 Pro 16GB에서 mlx-audio 0.5.9와 8비트 변환 모델로 돌립니다. 공식 예시는 CUDA 기준이어서 맥 경로는 제3자 패키지에 기댑니다.
얼마나 빠른가요?
편집부 맥에서 한국어는 음성 길이의 0.88배, 영어는 2.28배가 걸렸습니다. 같은 조각도 27.3초와 17.0초로 달랐습니다. 다른 작업이 함께 돌았을 수 있어 장비 성능 값으로 읽지는 마세요.
한국어 품질은 믿을 만한가요?
공식 표의 한국어 단어 오류율은 12Hz 1.7B-Base 1.755입니다. 편집부는 사람이 Sohee를 듣고 골랐지만 정식 품질 시험은 하지 않았습니다. 내 대본으로 시드 몇 개를 들어 보세요.
같은 소리를 다시 만들 수 있나요?
편집부 시험에서는 같은 문장 · 화자 · 시드 · 버전으로 파일 지문(md5)까지 같은 wav가 나왔습니다. 문장을 바꾸면 음색이 달라지고, 패키지 버전이 바뀌었을 때는 시험하지 않았습니다.
타입캐스트 · ElevenLabs와 비교하면 무엇이 다른가요?
비용 차이보다 일하는 방식이 다릅니다. 이 모델은 설치와 검수를 내가 맡는 대신 대본이 밖으로 나가지 않고 글자당 요금이 없습니다. 두 서비스는 설치 없이 목소리 목록과 편집 화면을 줍니다.
음성 복제도 쓸 수 있나요?
Base 모델이 지원하고, API 등록은 1개당 $0.01입니다. 편집부는 쓰지 않았습니다. 다른 사람 목소리라면 동의와 해당 국가 법을 먼저 확인하세요.
편집부 결론
대본을 자주 고치거나 밖으로 못 보내고, 같은 소리를 다시 만들어야 한다면 설치할 만합니다. 맥 M1 Pro 16GB로 쉼 정리 전 7분 17초 음성을 6분 23초에 합성했고 공개 판 조각을 파일까지 재현했습니다. 돈을 아끼려는 목적이면 다시 계산해 보세요. 같은 대본이 API로 약 34원이라, 설치와 대조에 드는 시간이 더 비쌉니다. 여러 한국어 목소리, 실시간 응답, 사람 손 없는 제작이 목적이면 고르지 마세요. 결과물은 전사 대조와 사람 듣기를 거친 뒤에 내보내세요. 일본어에서 숫자가 틀린 일이 실제로 있었습니다.
비슷한 도구
 ElevenLabs
미국 · 영국의 AI 음성 회사입니다. 다국어 TTS · 보이스 클로닝 · 더빙 · 효과음 · 음성 에이전트를 한 계정의 공용 크레딧으로 씁니다. 편집부는 쇼츠의 영어판 나레이션에 썼습니다.
 타입캐스트
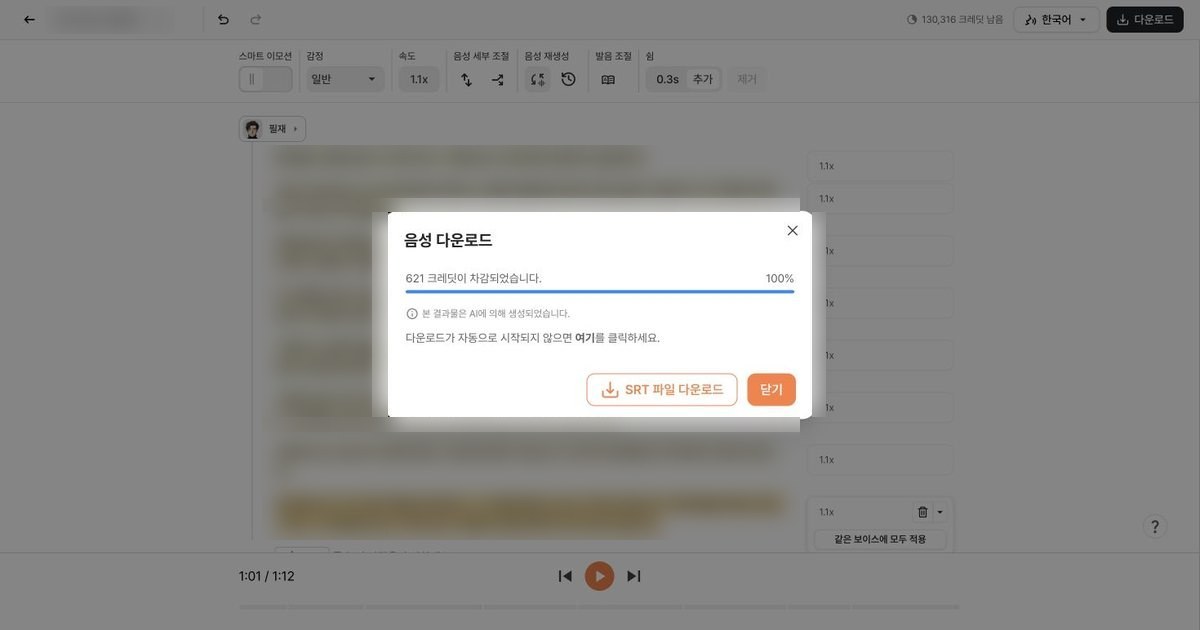
네오사피엔스가 만든 AI 음성 합성 서비스입니다. 한국어 보이스가 많고, 문장마다 감정 · 속도 · 끝음을 고칠 수 있습니다. 편집부가 AI 쇼츠의 한국어 나레이션을 만든 도구이며, 크레딧은 내려받을 때만 빠집니다.
 OpenAI Whisper
OpenAI가 코드와 모델 가중치를 MIT 라이선스로 공개한 음성 인식 모델입니다. 내 컴퓨터에서 무료로 돌립니다. 편집부는 AI 나레이션을 받은 직후 전사해 대본과 대조하는 검수에 씁니다.
로고와 아이콘은 각 회사의 상표이며, 도구를 알아보기 쉽게 표시한 것입니다. 표시가 제휴나 보증을 뜻하지는 않습니다.
이 카드를 쓴 방법
- 공식 제품 · 요금 페이지를 2026-11-07에 다시 열어 확인했습니다.
- 편집부가 실제로 쓴 도구는 요금제 · 기간 · 숫자로 기록을 남기고, 쓰지 않은 도구는 그렇다고 밝힙니다.
- 별점은 매기지 않습니다. 이 페이지에는 제휴 링크가 없습니다. 외부 링크는 모두 공식 사이트로 연결됩니다.
출처: QwenLM/Qwen3-TTS repository · Qwen3-TTS-12Hz-1.7B-CustomVoice model page · Qwen3-TTS LICENSE (Apache 2.0) · Alibaba Cloud Model Studio model pricing · Model Studio non-real-time speech synthesis · Model Studio free quota for new users · Model Studio Qwen-TTS voice list · mlx-audio (third-party Mac package) · 음성 · 오디오 AI 업계 지도(ko) · Voice and audio AI market map (en) · 편집부 글 듣기 샘플: 로봇 돈은 본체를 판 뒤에 갈린다(ko) · Our article audio sample: robotics market map (en)