AI 도구 / OpenAI Whisper
독립 리뷰 · 제휴 링크 없음
 OpenAI Whisper
OpenAI가 코드와 모델 가중치를 MIT 라이선스로 공개한 음성 인식 모델입니다. 내 컴퓨터에서 무료로 돌립니다. 편집부는 AI 나레이션을 받은 직후 전사해 대본과 대조하는 검수에 씁니다.
공식 사이트 ↗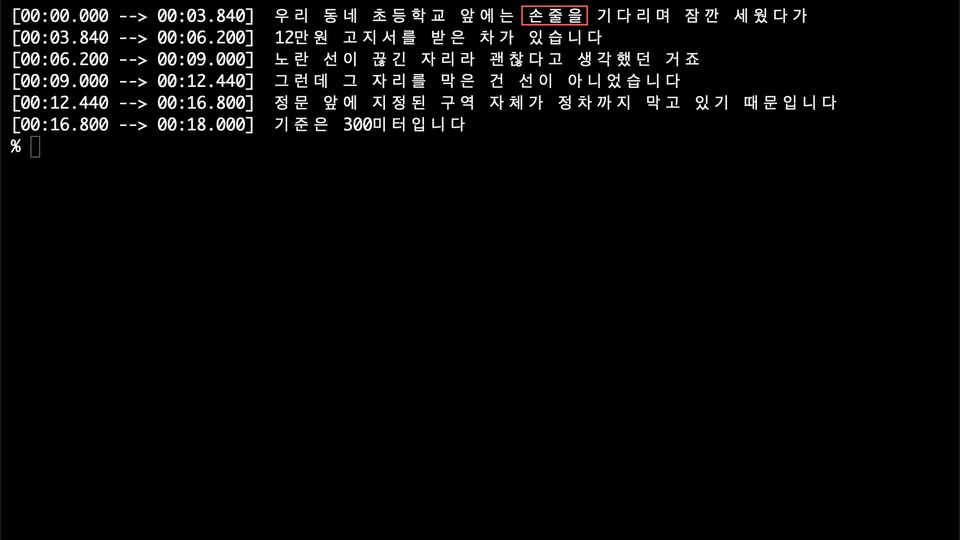
- 잘하는 것
- 내 컴퓨터에서 돌리는 다국어 음성 인식 · 단어 시각 추출
- 과금 방식
- 모델 자체는 무료 · 비용은 내 장비와 시간
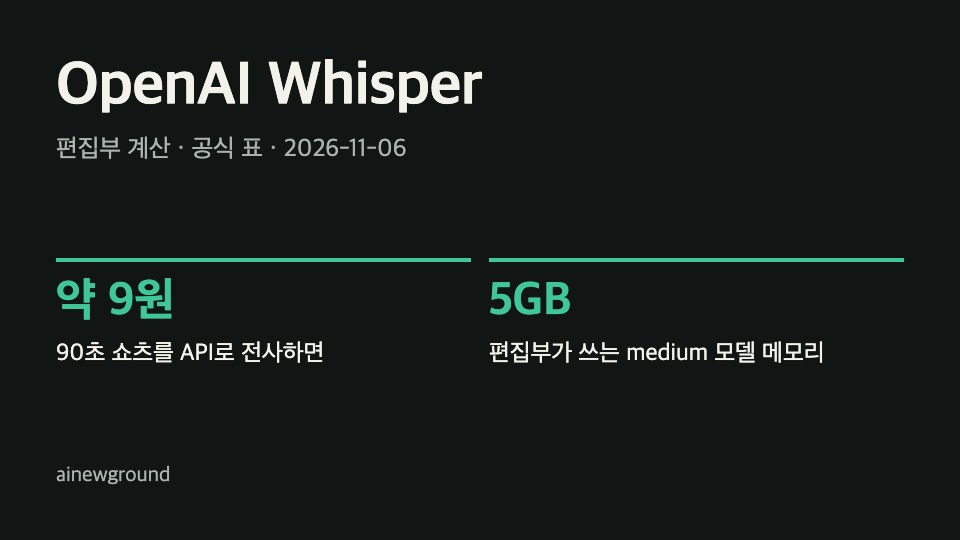
- 90초 쇼츠를 API로 전사하면(편집부 계산)
- 약 $0.0068(약 9원) · gpt-transcribe 분당 $0.0045 기준
- 필요 메모리
- tiny · base 약 1GB · small 2GB · medium 5GB · turbo 6GB · large 10GB(공식 표 · VRAM)
- 라이선스
- 코드 · 가중치 모두 MIT
- GitHub 별(2026-11-06)
- 약 11.2만 개
이 도구가 하는 일
Whisper는 가입하는 서비스가 아니라 내려받는 모델입니다. 같은 이름이 두 가지를 가리켜 헷갈리기 쉽습니다. 저장소의 공개 모델은 내 컴퓨터에서 돌고, API의 whisper-1은 2027-02-26에 닫힙니다. 모델 카드의 가장 새 모델은 2024년 9월의 turbo이고, API의 gpt-transcribe는 저장소 표에 없는 별개 제품입니다.
편집부는 이 모델을 받아쓰는 사람이 아니라 교정 보는 사람으로 씁니다. 영어판 쇼츠 10편의 마지막 대조에서 나레이션 307문장 중 277문장이 대본과 같았습니다. 양쪽 숫자를 낱말로 푼 뒤의 값입니다. 나머지 30문장은 차이로 표시됐고, 그중 2문장에 숫자 차이 표시가 붙었습니다. 깨끗한 합성 음성과 대본의 일치율이라, 잡음이나 여러 목소리가 섞인 실제 녹음의 정확도로 읽으면 안 됩니다.
얻는 것은 비싼 제작 단계 앞에 두는 값싼 두 번째 귀입니다. 대조 자체는 크레딧을 쓰지 않습니다. 결과는 들어 볼 곳의 목록이고, 고칠지는 사람이 정합니다.
편집부 사용 기록
- 편집부는 타입캐스트 나레이션을 받자마자 문단별로 전사해 대본과 대조합니다. 모델은 medium, 옵션은 condition_on_previous_text=False입니다.
- 이 검수를 넣기 전에는 AI 나레이션이 한 문장을 앞 문장 반복으로 바꿔 읽은 것을 샷 설계와 720p 제작 뒤에야 사람이 귀로 찾았습니다. 재생성에 240크레딧이 더 들었습니다(2026-10-01).
- 숫자 뒤 「번」을 「한 번」으로 읽은 오독도 이 대조로 잡았습니다. 고친 문단만 다시 받아 166크레딧으로 끝냈습니다(2026-10-04).
- 전사의 단어 끝 시각은 자동 편집에 그대로 믿으면 안 됩니다. 단어 끝을 잘못 잡은 값으로 자동 속도 조절을 돌렸더니 「다 치르고도」가 1.6~1.8배 빨라졌습니다. 그 뒤로 자동 조절을 뺐습니다.
- 세 세션이 medium을 동시에 돌리자 셋 다 25분 멈췄습니다(2026-10-08). 디스크 97% · 메모리 부족 때였습니다. 그 뒤로 전사는 한 번에 하나만 돌립니다.
- 모델 파일과 환경은 처음 받아 둔 곳을 다시 찾아 씁니다. 다른 폴더에서 「설치 안 됨」으로 잘못 판단해 새로 깐 적이 있습니다(2026-10-14).
- 확인한 것: 2026-11-06에 저장소 안내 · 모델 표 · 라이선스, OpenAI 음성 인식 문서, API 요금 쪽을 다시 읽었습니다.
- 확인 못 한 것: 한국어 정확도(WER)를 편집부 자료로 재지 않았고, turbo · large를 쓰지 않았고, Groq 등 다른 회사의 호스팅 값은 대조하지 않았습니다. 처리 시간도 장비마다 달라 적지 않았습니다.
이런 사람에게 맞습니다
AI 나레이션을 만드는 사람
완성 대본이 있으면 문장이 바뀌거나 숫자를 잘못 읽은 곳을 샷 설계 전에, 크레딧 없이 찾습니다.
음성을 밖으로 못 보내는 팀
외부 API로 파일이 나가지 않습니다. 녹음 동의는 여전히 내 몫이고, 모델 카드도 동의 없는 녹음의 전사를 말립니다.
일괄 처리를 짜는 개발자
MIT 조건과 파이썬 함수로 제품에 넣고, 계량기 없이 다시 돌립니다. 작업이 겹치지 않게 줄 세우는 코드는 직접 짜야 합니다.
검토할 시간이 있는 자막 작업자
명령 하나로 SRT · VTT 초안이 나옵니다. 교정은 따로 남습니다.
두 언어 트랙을 함께 굴리는 채널
편집부는 medium 하나로 한국어 · 영어 대조를 모두 돌립니다. 언어별 성능은 같지 않습니다.
이런 경우엔 맞지 않습니다
- 실시간 자막이나 화자 이름이 필요한 회의록: 모델 카드는 그대로는 실시간 전사에 쓸 수 없다고 적고, 명령줄과 전사 함수에는 화자 구분 옵션이 없습니다.
- 진료 · 법률처럼 판단에 직접 쓰이는 기록: 모델 카드가 위험이 큰 영역을 말리고, 실제로 말하지 않은 글이 나올 수 있다고 적습니다.
- 가끔 파일 몇 개만 옮기려는 사람: 오디오 1시간에 약 $0.27인 API가 Python · ffmpeg를 갖추는 시간보다 쌉니다.
핵심 기능
모델 여섯 크기
명령줄 기본값은 turbo입니다. --model을 빼면 편집부 기록에 없는 모델이 도니, 스크립트에는 크기를 적어 두세요.
상대 속도 표
A100 GPU에서 영어를 전사해 잰 값이라 노트북 속도를 말해 주지 않습니다. 편집부는 CPU로 돌려서 메모리 부담이 시스템 쪽으로 옵니다.
--task translate
영어로만 옮깁니다. turbo는 이 옵션을 줘도 원어를 돌려주니 medium이나 large를 씁니다.
condition_on_previous_text
기본은 켜짐입니다. 끄면 구간끼리 글이 조금 달라질 수 있어도 반복 오류에 덜 갇힌다고 코드에 적혀 있습니다. 편집부는 한국어 문단 대조에서 끕니다.
initial_prompt
대본의 지명 · 인명을 힌트로 넣습니다. 기본으로는 첫 구간에만 적용되고, carry_initial_prompt로 늘리면 앞 글 이어 받기 효과가 줄 수 있습니다.
word_timestamps
기본은 꺼짐이고 도움말에 「experimental」이라 적혀 있습니다. 들어 볼 위치 찾기까지만 맡기고, 강의 음성의 문장 경계는 대본 글자 비율로 따로 잡습니다.
출력 형식
기본값은 전부 쓰기라 파일이 여러 개 쌓입니다. -f로 하나만 고릅니다. 구간별 확신 값을 쓰려면 JSON을 봅니다.
.en 모델
tiny부터 medium까지 영어 전용이 있고 영어에서 더 낫다고 안내합니다. 편집부 영어 대조는 다국어 medium이라 차이를 재지 않았습니다.
편집부 실제 작업 순서
입력 고정
합성 파일을 받으면 언어와 medium 모델을 적고, 대본의 지명 · 인명을 힌트로 넣습니다.
나레이션만 전사
믹스는 쓰지 않습니다. 물 · 흙 소리가 섞인 믹스는 음량과 상관없이 오독해서 묻힘 검사도 나레이션 트랙으로 옮겼습니다.
양쪽 맞추기
한국어는 띄어쓰기 · 문장 부호를 빼고 비교합니다. 영어는 숫자를 양쪽 다 낱말로 풀고 won · one, for · four 같은 같은 소리를 하나로 칩니다.
차이 나누기
다섯 · 5, 미터 · m은 넘깁니다. 뜻이 바뀌는 곳만 잘라 small 모델로 힌트 있게 · 없게 다시 듣습니다.
사람 귀로 넘기기
분:초, 말, 전사가 들은 글, 판단을 표로 적습니다. 전사가 틀린 쪽일 때도 있습니다. 「205 won」이 $205.1로 적히면 숫자 구간만 다시 들어 가립니다.
틀린 곳만 고치기
다시 받을지는 사람이 듣고 정합니다. 166크레딧으로 끝낸 수정은 전체를 다시 받으면 약 980크레딧입니다. 문단 경계 무음에서 잇고 새 구간을 또 전사합니다. razed가 raised로 들리듯 뜻이 뒤집히면 대본 낱말을 바꿉니다.
생성 클립 검사
조립 전에 Flow 클립마다 small로 전사해 말소리를 찾습니다. no_speech_prob 0.5 미만, avg_logprob −1.0 초과를 봅니다. 사람이 51클립 중 1개에서 영어 음성을 먼저 듣고 넣은 단계입니다.
OpenAI Whisper 요금제
내 컴퓨터(오픈소스)
- 코드 · 가중치 무료 · 사용량 제한 없음
- 전기 · 장비 · 시간은 내 몫
가격 확인 2026-11-06 · 공식 요금 페이지 ↗ · ≈ 표시는 2026-10-20 환율 1달러 = 1,330.79원으로 환산한 값입니다.
Whisper 저장소에는 요금제가 없습니다. 비교용 API 값은 OpenAI API 요금 쪽에서 2026-11-06에 읽었습니다(gpt-transcribe 분당 $0.0045 · gpt-4o-mini-transcribe $0.003 · gpt-4o-transcribe $0.006). 환산은 쪽 아래 환율 기준입니다.
강점
- 코드와 가중치가 MIT라 상업 제품에 넣기 쉬움
- 음성이 내 컴퓨터 밖으로 나가지 않음
- 사용량 과금이 없어 같은 파일을 여러 번 돌려도 돈이 늘지 않음
- 모델 크기를 장비에 맞춰 고를 수 있음
- 다국어 전사 · 번역 작업을 명령 하나로 돌릴 수 있음
- 단어 시각을 뽑아 자막 · 편집 위치를 찾는 재료로 쓸 수 있음(자동 판단은 사람이 확인)
고려할 점
- 돈을 아끼려고 고를 도구가 아닐 수 있습니다. 90초 한 편의 API 전사는 약 9원이라 100편이어도 $1이 안 됩니다. 로컬의 이점은 비용보다 데이터 통제와 반복 처리입니다.
- 메모리를 생각보다 많이 씁니다. medium은 공식 표로 VRAM 5GB이고 동시에 여러 개를 돌리면 멈출 수 있습니다. 장비를 새로 사면 전사 비용 비교는 뒤집힙니다.
- 저장소의 Whisper와 OpenAI API의 음성 인식 모델은 다른 경로입니다. API의 whisper-1 · gpt-4o-transcribe 계열은 2027-02-26 종료 예정이라, API를 쓰는 코드는 gpt-transcribe로 옮겨야 합니다.
- API는 파일당 25MB가 상한입니다. 긴 강의 · 팟캐스트를 API로 넘기려면 잘라야 하고 경계 처리 작업이 따로 듭니다.
- 언어에 따라 성능이 크게 다릅니다. 저장소도 언어별 오차가 넓게 갈린다고 적습니다. 한국어 숫자 · 고유명사는 사람이 대조해야 합니다.
- 전사가 맞아도 발음이 맞다는 뜻은 아닙니다. 소리로 뜻이 뒤집히는 연음은 전사표에 안 드러날 수 있어 사람이 들어야 합니다.
대안
- ElevenLabs — 화자 32명까지 구분과 3GB 파일이 필요하면 ElevenLabs Scribe v2를 고르세요. 오디오 1시간 $0.22이고 음성은 외부로 나갑니다.
- OpenAI API (gpt-transcribe) ↗ — 장비 없이 가끔 쓰면 gpt-transcribe를 고르세요. 오디오 1시간 약 $0.27, 파일당 25MB이고 단어 시각은 안내상 whisper-1 쪽입니다.
자주 묻는 질문
Whisper 요금은 얼마인가요?
2026-11-06 기준 공개 저장소의 Whisper는 코드와 가중치 모두 MIT로 무료입니다. 비용은 내 장비입니다. 장비 없이 쓰려면 OpenAI API의 gpt-transcribe가 분당 $0.0045, gpt-4o-mini-transcribe가 분당 $0.003입니다.
무료로 상업적 용도에 써도 되나요?
저장소는 코드와 가중치가 MIT 라이선스라고 적습니다. 상업 제품 포함 조건은 라이선스 전문을 확인하세요. 전사 대상 음성의 권리는 별도 문제입니다. 법률 조언은 아닙니다.
어떤 모델을 고를까요?
공식 표에서 VRAM은 tiny · base 약 1GB, small 2GB, medium 5GB, turbo 6GB, large 10GB입니다. 편집부는 나레이션 대조에 medium을 씁니다. 다른 모델과 정확도를 비교하지는 않았습니다.
로컬과 API 중 무엇이 쌀까요?
장비가 이미 있으면 로컬은 추가 비용이 거의 없지만, 90초 한 편의 API 전사도 약 9원입니다. 양이 아주 많지 않으면 비용 차이는 작습니다. 음성을 밖으로 보내면 안 되거나 자주 다시 돌릴 때 로컬을 고릅니다.
API를 해지하거나 환불받을 일이 있나요?
저장소판은 결제 자체가 없어 해지 · 환불이 없습니다. API는 사용량 과금이고 OpenAI 약관을 따릅니다. 약관은 법이 요구하는 경우를 빼고 결제액을 환불하지 않는다고 적습니다. whisper-1은 2027-02-26 종료 예정입니다.
한국어 전사는 믿을 만한가요?
편집부는 정확도를 수치로 재지 않았습니다. 대본과 대조해 다른 곳을 찾는 검수에는 유용했고, 표기 차이(다섯과 5)는 넘겨야 합니다. 대본이 없는 전사는 숫자와 고유명사를 사람이 확인하는 것을 전제로 쓰세요.
다른 전사 도구와 비교하면 어떤가요?
ElevenLabs Scribe, 호스팅 API 같은 대안이 있습니다. 편집부는 Whisper만 전사 검수에 썼고 같은 음성으로 비교한 적이 없어 순위를 매기지 않습니다.
전사가 멈춘 것 같으면 무엇부터 보나요?
다른 전사 프로세스가 돌고 있는지, 디스크 여유와 메모리를 먼저 봅니다. 편집부가 멈춤을 겪은 것은 같은 모델을 세 개 겹쳐 돌렸을 때였습니다.
편집부는 나레이션 검수를 어떤 순서로 하나요?
합성 파일을 받은 직후 문단별로 medium 모델로 전사합니다. condition_on_previous_text를 꺼서 앞 문단의 오류가 번지지 않게 합니다. 전사문을 대본과 비교해 다른 곳을 표로 뽑고, 표기 차이(다섯과 5, 미터와 m)는 넘깁니다. 진짜 오독만 그 문단을 다시 받습니다. 다음 단계로 넘어가기 전에 끝내야 재생성 비용이 작습니다.
처음 설치할 때 무엇이 필요한가요?
저장소 안내에 따라 Python과 PyTorch, 그리고 명령줄 도구 ffmpeg가 필요합니다. 첫 실행 때 모델 파일을 내려받습니다. 편집부가 쓰는 medium 파일은 약 1.5GB입니다. 설치한 환경과 모델 경로를 적어 두면 같은 설치를 반복하지 않습니다.
API에서 쓰던 whisper-1은 어떻게 되나요?
OpenAI 문서에 따르면 whisper-1과 gpt-4o-transcribe 계열은 2027-02-26에 종료될 예정이고, 녹음 음성 전사에는 gpt-transcribe를 권합니다. 이 일정은 API 이야기이고, 내려받아 돌리는 공개 저장소판은 별개입니다. 다만 모델 업데이트 여부는 저장소를 직접 보세요.
편집부 결론
비교할 대본이 있거나 음성을 밖으로 못 보내고, 같은 파일을 자주 다시 돌린다면 설치할 만합니다. 늦게 찾은 한 문장에 240크레딧이 들었고, 대조는 크레딧이 들지 않습니다. 사람 손 없는 전사, 실시간 자막, 화자 구분이 목적이면 고르지 마세요. 오디오 1시간에 gpt-transcribe 약 $0.27, Scribe v2 $0.22라 설치 시간이 더 비쌉니다. API 코드를 옮길 때는 OpenAI 안내가 단어 시각을 whisper-1에만 묶어 두었으니, 시각에 기대는 작업은 먼저 확인하세요. 전사문은 음성의 최종 판정이 아니라 들어 볼 곳의 목록으로 읽으면 됩니다.
비슷한 도구
 ElevenLabs
미국 · 영국의 AI 음성 회사입니다. 다국어 TTS · 보이스 클로닝 · 더빙 · 효과음 · 음성 에이전트를 한 계정의 공용 크레딧으로 씁니다. 편집부는 쇼츠의 영어판 나레이션에 썼습니다.
 Qwen3-TTS
알리바바 Qwen 팀이 Apache 2.0으로 공개한 음성 합성 모델입니다. 내 컴퓨터에서 돌리면 요금이 없고, 비용은 장비와 시간입니다. 편집부는 로봇 편 글 듣기 4개 언어와 강의 음성을 맥에서 이 모델로 만듭니다.
 타입캐스트
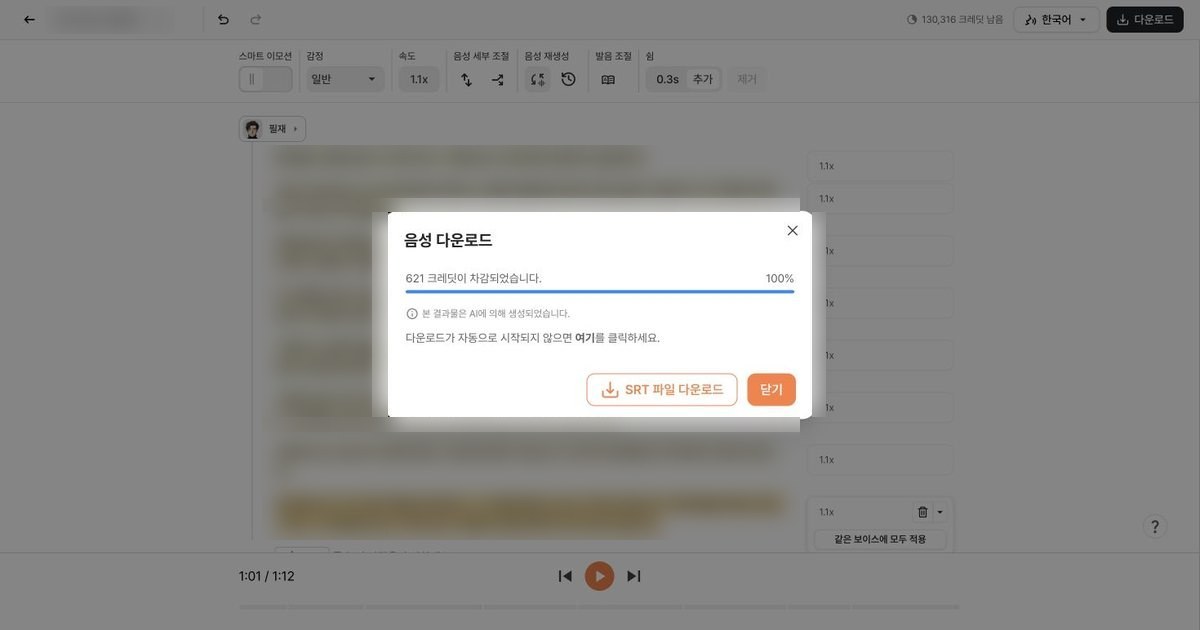
네오사피엔스가 만든 AI 음성 합성 서비스입니다. 한국어 보이스가 많고, 문장마다 감정 · 속도 · 끝음을 고칠 수 있습니다. 편집부가 AI 쇼츠의 한국어 나레이션을 만든 도구이며, 크레딧은 내려받을 때만 빠집니다.
로고와 아이콘은 각 회사의 상표이며, 도구를 알아보기 쉽게 표시한 것입니다. 표시가 제휴나 보증을 뜻하지는 않습니다.
이 카드를 쓴 방법
- 공식 제품 · 요금 페이지를 2026-11-06에 다시 열어 확인했습니다.
- 편집부가 실제로 쓴 도구는 요금제 · 기간 · 숫자로 기록을 남기고, 쓰지 않은 도구는 그렇다고 밝힙니다.
- 별점은 매기지 않습니다. 이 페이지에는 제휴 링크가 없습니다. 외부 링크는 모두 공식 사이트로 연결됩니다.
출처: openai/whisper repository · Whisper model card · Whisper LICENSE (MIT) · OpenAI speech to text guide · OpenAI API pricing · 음성 · 오디오 AI 업계 지도(ko) · Voice and audio AI market map (en) · Whisper transcribe.py (command-line options) · ElevenLabs speech to text documentation · ElevenLabs API pricing